
MacでローカルLLM(自分のPCの中で動かすAI)をどこまで実用にできるのか。手元のMacBook Pro(M4 Max、メモリ64GB)で、Ollamaを使って8Bから70Bまでのモデルの速度を測ってみた。
ちょうどM5 Maxが出て、さらに10月には無印のM6を積んだMacBook Proも発表された。「M4 Maxを持っているけど、M5 Maxに買い替える価値はあるのか」「M6の方が新しいから速いのでは?」というあたりも、測った数字と公表値で整理しておく。
測った環境
| Mac | MacBook Pro 14インチ(M4 Max 16コアCPU・40コアGPUの上位版、ユニファイドメモリ64GB) |
|---|---|
| メモリ帯域 | 546GB/s(Apple公表値) |
| ソフト | Ollama 0.31.1 |
| 測り方 | 温度0、文脈長8192。短い質問(約70トークン)と長い文章(約3,800トークン)の要約をそれぞれ3回ずつ実行し、中央値をとった。モデルの読み込み直後の1回は除外。 |
速さの単位は「tok/s」(1秒あたりのトークン数)。日本語だとおおよそ1トークン=1〜2文字くらいと思っておけばいい。
M4 Max 64GBの実測結果
| モデル | 大きさ | 文字を出す速さ | 長文の読み込み | 使ったメモリ |
|---|---|---|---|---|
| Qwen3 8B | 8B | 75.9 tok/s | 746 tok/s | 6.1GB |
| Devstral 24B | 24B | 30.0 tok/s | 284 tok/s | 14GB |
| Qwen3-Coder 30B | 30B(MoE) | 100.3 tok/s | 1,110 tok/s | 18GB |
| Llama 3.3 70B | 70B | 10.6 tok/s | 69.9 tok/s | 43GB |
人が読む速さはせいぜい10〜20 tok/s程度なので、30 tok/sを超えると「待たされている」感じはほぼない。
30Bが8Bより速いのはなぜか
意外だったのはQwen3-Coder 30Bが8Bより速かったこと。このモデルは「MoE(専門家の混合)」という作りで、全体は30Bあっても、1文字出すごとに使うのはそのうちの約3B分だけ。だから速い。
ただし、使わない部分も含めて全部メモリに載せておく必要がある。今回は18GBを使った。速さを決めるのは「一度に使う量」と「メモリ帯域」、動かせるかどうかを決めるのは「メモリの量」。ここがMacを選ぶ時の分かれ目になる。
70Bは動くが、実用は「待てるかどうか」
Llama 3.3 70B(4bit、43GB)は、64GBのM4 Maxで問題なく動いた。文字を出す速さは10.6 tok/sで、読む速さよりは少し遅いが会話には使える。
きついのは長文の読み込みで、約4,100トークンの文章を読ませると、回答が出始めるまでに約1分(69.9 tok/s)かかった。海外の報告ではM5 Maxで70Bの4bitが約13 tok/s(出典)。生成はM4 Maxの約1.2倍だが、M5 Maxは読み込みが最大4倍速いとされているので(次の章で説明)、この1分が15〜20秒程度まで縮む計算になる。70Bを長文で使うなら、M5 Maxの差がいちばん出るところだ。
なぜ「Max」なのか:メモリ量・帯域・GPUが無印の4倍
ローカルLLMで使えるモデルの大きさと速さは、メモリ量・メモリ帯域・GPUコア数の3つで決まる。大事な順に並べるとこうなる。
- メモリ量:モデルが載るかどうか。載らなければ、ほかがどれだけ速くても動かない。70B(約43GB)を動かすには48GB以上が要る。
- メモリ帯域:文字を出す速さ。1文字出すたびにモデルの重みを読み出すので、速さは帯域にほぼ比例する。返答のたびに毎回効く。
- GPUコア数:長い入力を読み込む速さ。資料やソースコードを丸ごと渡した時、回答が出始めるまでの待ち時間はここで決まる。長文やコーディングに使うなら、帯域と同じくらい効く。
そして、この3つはどれか1つだけ多くても効果が出ない。メモリが多くても帯域が狭ければ、大きいモデルは載るが遅い。帯域が広くてもGPUが少なければ、長文を渡すたびに待たされる。GPUが多くてもメモリが少なければ、大きいモデルがそもそも載らない。
Appleのチップは、ランクが上がると3つがまとめて増える作りになっている。M5世代で並べるとこうなる。
| チップ | CPU | GPU | メモリ帯域 | メモリ最大 | 30B 文字を出す速さ |
70B 文字を出す速さ |
長文の読み込み (M5 Max 40コア比) |
|---|---|---|---|---|---|---|---|
| 無印M6 | 12コア | 12コア | 最大170GB/s | 32GB | 約31 tok/s | 載らない | 約1/3 |
| M5 Max(40コアGPU版) | 18コア | 40コア | 614GB/s | 128GB | 約113 tok/s | 約12 tok/s | 基準 |
| M5 Max(32コアGPU版) | 18コア | 32コア | 460GB/s | 36GB | 約84 tok/s | 載らない | 約0.8 |
| M5 Pro | 15〜18コア | 16〜20コア | 307GB/s | 64GB | 約56 tok/s | 約6 tok/s | 約1/2 |
| 無印M5 | 10コア | 10コア | 153GB/s | 32GB | 約28 tok/s | 載らない | 約1/4 |
| M4 Max(40コアGPU版) | 16コア | 40コア | 546GB/s | 128GB | 100.3 tok/s | 10.6 tok/s | 約1/4〜1/3.6 |
出典:スペックはApple公表値。M4 Maxの速さは手元の実測(Qwen3-Coder 30B・Llama 3.3 70B、Ollama)。ほかのチップの文字を出す速さはM4 Maxの実測をメモリ帯域の比で、長文の読み込みはGPUコア数の比で換算した目安。M4 Maxの読み込みはAppleの「M5 Maxで最大4倍」と海外の実測(約3.6倍)から。
※M5 Max(32コアGPU版)はメモリ36GBの構成しかない(48GB以上は40コアGPU版のみ。M5 Proの64GBは20コアGPU版のみ)。帯域がちょうど4分の3(460÷614)なので、メモリの経路も4分の3に減らされていると見られるが、Appleは理由を公表していない。
同じM5世代で比べると、Maxは無印に対して、メモリ量・帯域・GPUのどれもが4倍(Proは2倍)。3つが揃って増えるので、「大きいモデルが載る」「文字を出すのが速い」「長文を渡しても待たない」が同時に成り立つ。ローカルLLMでMaxを選ぶ一番の理由はここだ。
表のいちばん下は、1世代前のM4 Max。旧世代でも、帯域とメモリ量は新しい無印M6やM5 Proより上だ。文字を出す速さと載るモデルの大きさでは、世代の新しさよりMaxかどうかの方が効く。M4 Maxが弱いのは長文の読み込みだけで、ここはM5世代からGPUの各コアにNeural Acceleratorが入った差が出る(次の章で説明)。
逆にCPUのコア数は、無印とMaxで2倍も変わらない。LLMの計算はGPUとメモリ側で行うので、CPUのコア数は速さにほとんど効かない。スペック表を見る時は、CPUよりもGPUのコア数・メモリ帯域・メモリ最大の3列を見ればいい。
たとえばM5 Proの64GBなら70Bも載る。ただ、帯域とGPUはMaxの半分なので、手元のM4 Maxで10.6 tok/sだった70Bは、帯域比で6 tok/s前後になる計算だ(目安)。「載るけど遅い」になる。
同じMaxでも、GPU 32コア版は別物
注意したいのは、M4 MaxにもM5 MaxにもGPUが32コアの下位版があること。今回測ったのは40コアの上位版だ。
| チップ | CPU | GPU | メモリ帯域 | 選べるメモリ |
|---|---|---|---|---|
| M5 Max 下位版 | 18コア | 32コア | 460GB/s | 36GBのみ |
| M5 Max 上位版 | 18コア | 40コア | 614GB/s | 48〜128GB |
| M4 Max 下位版 | 14コア | 32コア | 410GB/s | 36GBのみ |
| M4 Max 上位版 | 16コア | 40コア | 546GB/s | 48〜128GB |
下位版は、さっきの3つがすべて下がる。
- メモリ量:36GBしか選べない。OSやアプリの分を引くと70Bは載らず、30Bクラスが上限になる。
- メモリ帯域:上位版の約75%。文字を出す速さもそのくらいが目安。
- GPUコア数:40→32コアで、長文の読み込みは約8割になる計算。M5の「読み込み最大4倍」も、各GPUコアに入ったNeural Acceleratorによるものなので、コア数がそのまま効く。
どれも仕様からの目安で、32コア版は手元では測れていない。それでも、値段だけ見て下位版のMaxを選ぶと、Maxにした意味が半分なくなる。選ぶならMaxの40コアGPU版だ。
M5 Maxの40コアGPU版はAmazonでも買える。下は16インチ・メモリ48GB・SSD 2TBの構成。商品名の「40コアGPU」を確認してから選びたい。


そもそも、なぜAppleはLLMの速さをここまで推すのか
M5 MaxやM6の発表を見ると、AppleはCPUの速さよりも「AI性能が何倍」「LLMの処理が何倍」という数字を前面に出している。M6の発表でも、まずM1比で最大13倍のAI性能という数字が出てくる。なぜそこまでLLMの速さを推すのか。理由は大きく4つあると思う。
1. AppleのAIは「端末の中で動かす」のが前提
Apple Intelligence(新しいSiriなど)は、できるだけiPhoneやMacの中で処理する方針をとっている。プライバシーを売りにでき、クラウドの費用も抑えられる。そのぶん「手元でLLMがどれだけ速く動くか」が、そのまま製品の価値になる。
2. Macは大きいモデルを1台で動かしやすい
MacはCPUとGPUが同じメモリ(ユニファイドメモリ)を共有していて、M5 Maxなら最大128GBをAIに回せる。一般的なPCでAIを動かすのはグラフィックボードで、そのメモリは数十GBが上限になる。70Bのような大きいモデルを1台で手軽に動かせる選択肢は限られていて、開発者やAI好きの間で「ローカルLLMならMac」という流れができている。
ちなみにWindows側でも、AMDのRyzen AI Maxのようにメモリを共有する方式のPCが出てきている。こちらは以前「15万円で手に入れる、クラウド不要のAI開発環境」で書いた。
3. 弱点だった「計算力」を埋めた
これまでのMacは、メモリは大きいのに計算力がNVIDIAのGPUより弱く、長い入力を読み込む処理が遅かった。上の実測で、70Bに長文を読ませると回答が出始めるまで約1分かかったのがまさにそれだ。M5世代はここを直したので、「最大4倍」と大きくアピールしている(仕組みは次の章で説明)。
4. CPUの伸びが鈍く、大きい数字を出しやすいのがAI
CPUの性能は、世代ごとに1〜2割程度しか伸びなくなっている。AIの処理なら、専用の回路を足すだけで「4倍」「13倍」という派手な数字が出る。買い替えを促すにはわかりやすい数字だ。
ただ、次の章で見るとおり、派手な数字が効くのは処理の一部だけ。どこが速くなって、どこは変わらないのかを分けて見る必要がある。
「Neural Engine」と「Neural Accelerator」は別物
名前が似ていてややこしいが、この2つは別の部品だ。
| Neural Engine | Neural Accelerator | |
|---|---|---|
| 場所 | チップ内の独立したAI専用回路 | M5世代から、GPUの各コアの中 |
| 主な用途 | Apple自身の機能(写真の処理、Siriなど)を省電力で動かす | GPUでの行列計算(AIの計算の中心)を速くする |
| OllamaなどのローカルLLM | ほぼ使われない | LLMは主にGPUで動くので、効くのはこちら |
M5 Maxの「最大4倍」は、このGPU側のNeural Acceleratorによるものだ。
M5 Maxに買い替えるとどれだけ速くなるのか
M5 Maxは2026年3月に発表された。メモリ帯域は最大614GB/sで、M4 Maxの546GB/sから約12%増。ローカルLLMの「文字を出す速さ」はほぼメモリ帯域で決まるので、ここは1割ちょっとの差にとどまる。
海外の比較テストでも、7BクラスのモデルでM4 Maxが83.1 tok/s、M5 Maxが119.9 tok/sという結果が出ている(出典)。手元の8Bの75.9 tok/sも、M4 Max側の数字と大きくは外れていない。
一方で、長い文章を読み込む処理はM5 Maxで大きく速くなっている。Appleは発表で、M5 MaxのLLMプロンプト処理(長い入力を読み込んで最初の1文字が出るまで)をM4 Max比で最大4倍としている(Appleの発表内容)。llama.cppでの実測でも約3.6倍という報告がある(出典)。
なぜここだけ大きく伸びるのか。LLMの処理は2段階に分かれる。長い入力を読み込む段階は「計算の量」で速さが決まり、1文字ずつ出す段階は「メモリから重みを読み出す速さ(帯域)」で決まる。M5世代はGPUの各コアに行列計算用のNeural Acceleratorが入ったので、計算で決まる読み込み側が大きく速くなった。一方、帯域は546→614GB/sの約12%増にとどまるので、文字を出す速さは1割ちょっとしか変わらない、という理屈だ。
なお「最大4倍」はAppleの条件での最大値で、モデルや使うソフトによって差は変わる。Ollamaなどが新しいNeural Acceleratorを使えるかどうかでも結果が変わるので、ここは自分で測れていない数字として読んでほしい。
手元の結果でも、長文の読み込みは30B以下で数百〜1,100 tok/s、70Bだと約70 tok/s。数万トークンの資料やソースコードを丸ごと読ませると、回答が出始めるまでに数十秒〜分単位で待つことになる。M5 Maxで体感が変わるのは、この「出始めるまで」の待ち時間だ。
| M4 Max | M5 Max | |
|---|---|---|
| メモリ帯域 | 546GB/s | 614GB/s |
| メモリ最大 | 128GB | 128GB |
| 文字を出す速さ | 基準 | 約1.1〜1.4倍(帯域差と海外実測) |
| 長文の読み込み | 基準 | 最大4倍(Apple)、約3.6倍(海外実測) |
つまり、M4 Maxを持っているなら急いで買い替えるほどではない。長い資料を読ませる使い方が中心なら差は大きい。これからローカルLLM用にMacを買うなら、M5 Maxの40コアGPU版を選んでおけば間違いない。
無印のM5・M6では何が違うのか
10月27日にAppleは無印のM6を積んだ14インチMacBook Proを発表し、11月6日に発売した(Apple)。M5比でAI処理が最大25%速く、LLMの最初の回答が出るまでの時間は最大1.3倍速いとされている。
新しいチップなので速そうに見えるが、ローカルLLMで効くのは、前に書いたメモリ量・帯域・GPUコア数の3つだ。
| 無印M6 | M5 Max | 無印M5 | M4 Max | |
|---|---|---|---|---|
| メモリ最大 | 32GB | 128GB | 32GB | 128GB |
| メモリ帯域 | 最大170GB/s | 614GB/s | 153GB/s | 546GB/s |
| CPU | 12コア | 18コア | 10コア | 16コア |
| GPU | 12コア | 40コア | 10コア | 40コア |
| 70Bモデル(約43GB) | 載らない | 動く | 載らない | 動く |
メモリ帯域はM4 Maxの約3分の1。文字を出す速さは帯域にほぼ比例するので、同じモデルならM6でもM4 Maxの3分の1前後が目安になる(これは帯域比からの目安で、実測ではない)。
GPUもM6で12コアと、Maxの40コアの3分の1以下。M6もGPUの各コアにNeural Acceleratorが入っているが、コア数の差は埋まらない。長文の読み込みも、M5 Maxと比べるとおおむね3分の1になる計算だ(目安)。なお、M4 MaxはNeural Acceleratorが入る前の世代なので、M6との読み込みの比較はコア数だけでは決まらない。
そしてメモリが最大32GBなので、OSやアプリの分を引くと、LLMに使えるのは20GB台。Qwen3-Coder 30B(18GB)がギリギリ、70Bは載らない。新しさではM6が上でも、ローカルLLMに限っては型落ちのM4 Maxの方が段違いに速く、大きいモデルも動く。
とはいえ、まず8Bクラスを触ってみたいだけなら、M6のMac miniは安く始められる入り口になる。8Bは手元で6GBほどしか使わないので、16GBでも動く。ただ、30Bクラスまで試すならメモリは24GB以上が欲しい。M6のMacBook Proでは16GB構成だけ帯域が153GB/sに下がる(24GB・32GBは170GB/s)ので、その意味でもメモリは増やしておきたい。


ちなみに、M6 ProやM6 Maxは今回発表されていない。今MaxクラスのMacを買うなら、選択肢はM5 Max(またはM4 Maxの整備品・中古)になる。どちらも40コアGPU版かを確認したい。
Macを買うならメモリは何GBにするか
- 32GB以下:8B〜14Bクラスが快適。30BのMoEはギリギリ。
- 64GB:30Bクラスは余裕、70Bの4bitも動く。手元の構成で、ローカルLLMを試すなら一番バランスがいいと感じている。
- 128GB:70Bを文脈長を長めにして使う、複数モデルを同時に載せる、といった使い方まで視野に入る。M5 Maxの40コアGPU版で選べる。
Macのメモリは後から増やせない。迷ったら一段上にしておくのがいい。
Max構成のMacは高い。楽天ポイントを貯めているなら、Apple Gift Cardに替えてApple Storeで使う手がある。やり方は「Apple製品を楽天ポイントで買う方法」にまとめた。
周辺機器:Thunderbolt 5のドック
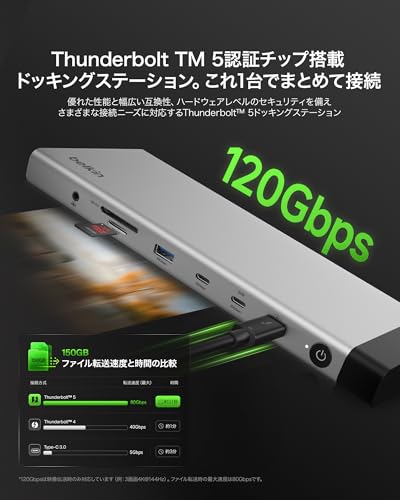
M4 Max・M5 MaxのMacBook ProはThunderbolt 5に対応している。ローカルLLMのモデルは1つで数GB〜40GB超あり、増えてくると内蔵SSDを圧迫する。外付けSSDやモニターをまとめてつなぐなら、Thunderbolt 5対応のドックを1台置いておくと便利だ。
選ぶなら、Mac向けの周辺機器で定評のあるOWCとBelkinのどちらかにしておくと安心だ(どちらも手元では使っていない)。
OWC Thunderbolt 5 Dock:11ポート。UHS-II対応のSD・microSDカードスロットと2.5GbEの有線LANがあり、写真や動画も扱うなら便利。


Belkin Thunderbolt 5 ドッキングステーション(14-in-1):14ポートでMacへ140W給電、最大3画面に出力できる。保証は3年。




まとめ
- M4 Max 64GBで、8B〜30Bは快適、70Bも動く。
- M5 MaxはM4 Maxより文字を出す速さは1割ちょっと、長文の読み込みは最大4倍。持っているなら急がなくていい、これから買うならM5 Max。
- ローカルLLMはメモリ量・帯域・GPUコア数の3つが揃って速くなる。Maxは同世代の無印に対して3つとも4倍。
- MaxはGPU 32コア版と40コア版で別物。32コア版はメモリ36GBのみ・帯域約75%なので、選ぶなら40コア版。
- 無印のM5・M6はメモリ32GB・帯域153〜170GB/s・GPU 10〜12コアで、ローカルLLMではMaxと段違いの差がある。
参照元
- Apple Newsroom:M6搭載の新しい14インチMacBook Pro(2026年10月27日)
- MacRumors:M6 MacBook Proのメモリ帯域(16GB構成は153GB/s)
- MacDailyNews:Apple、M5 Pro・M5 Max搭載MacBook Proを発表(Appleの発表文)
- Apple:MacBook Pro(M5 Pro・M5 Max)技術仕様(GPUコア数とメモリ帯域・メモリ構成)
- AppleInsider:M5 Pro・M5 Maxのメモリ帯域
- MacBook Pro M4 Max vs M5 Max Quick LLM Speed Test
- M5 Max vs M4 Max for Local LLMs(llmcheck)

コメント